FFI
使用 Bun 的 FFI 模块高效地从 JavaScript 调用本地库
使用内置的 bun:ffi 模块从 JavaScript 高效地调用本地库。它适用于任何支持 C ABI 的语言,包括 Zig、Rust、C/C++、C#、Nim 和 Kotlin。
dlopen 用法(bun:ffi)
打印 sqlite3 的版本号:
import { dlopen, FFIType, suffix } from "bun:ffi";

// `suffix` 根据平台可能是 "dylib"、"so" 或 "dll"
// 你不必一定要使用 "suffix",它只是为方便准备的
const path = `libsqlite3.${suffix}`;

const {
  symbols: {
    sqlite3_libversion, // 要调用的函数
  },
} = dlopen(
  path, // 库名或文件路径
  {
    sqlite3_libversion: {
      // 无参数,返回字符串
      args: [],
      returns: FFIType.cstring,
    },
  },
);

console.log(`SQLite 3 版本: ${sqlite3_libversion()}`);
性能
根据我们的基准测试,bun:ffi 的速度大约是通过 Node-API 实现的 Node.js FFI 的 2-6 倍。
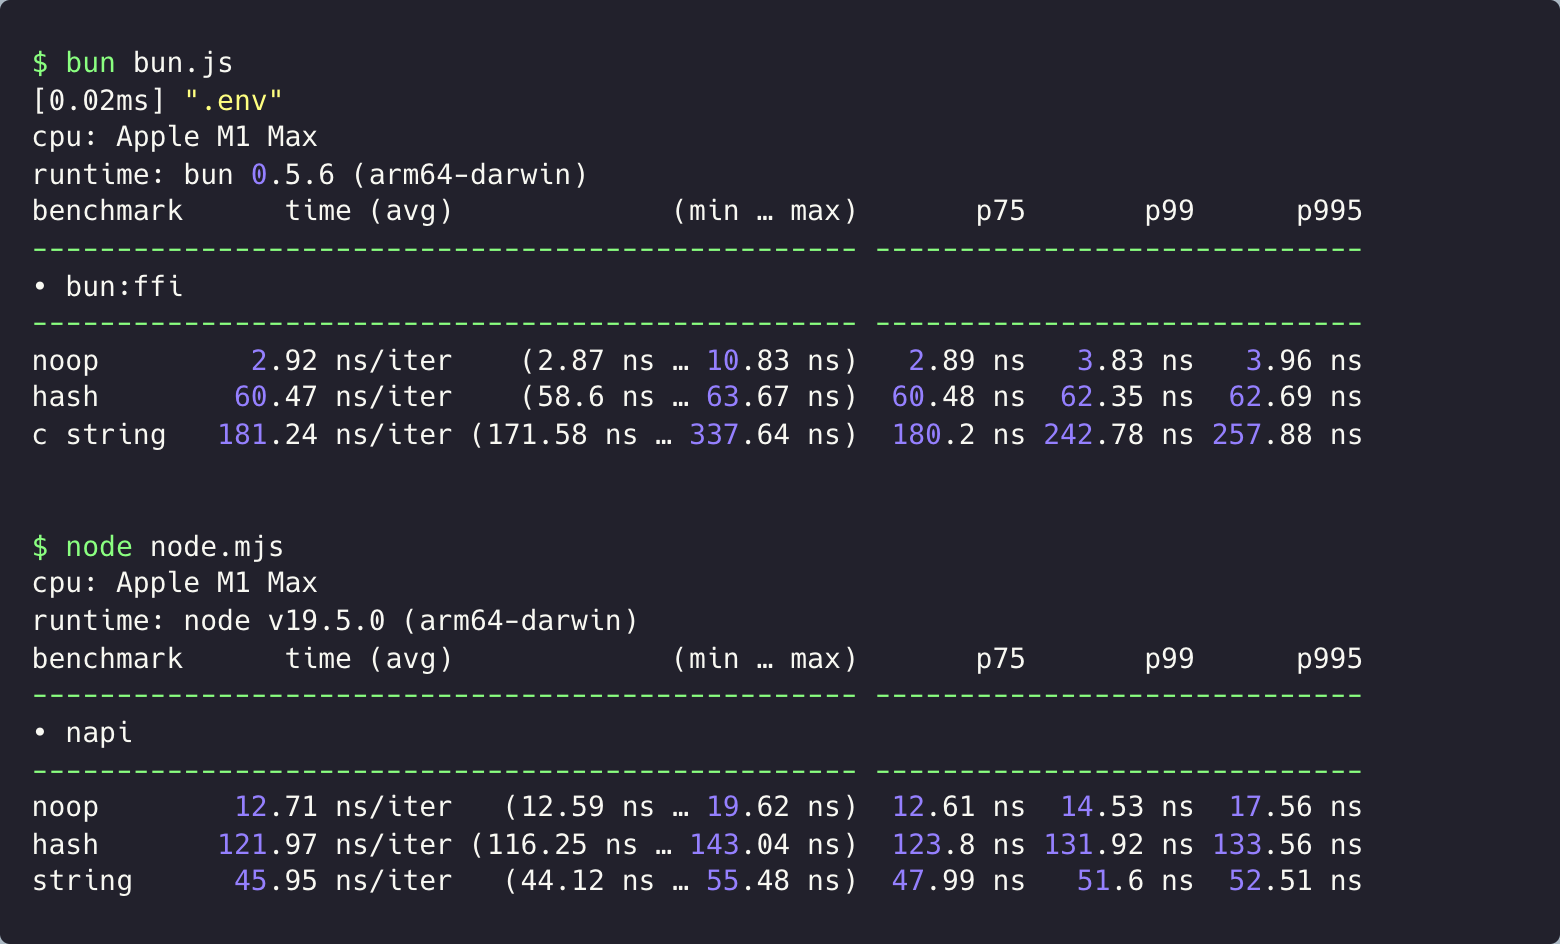
Bun 的 JavaScript 引擎(JavaScriptCore)原生实现了 dlopen、linkSymbols、CFunction 和 JSCallback。参数转换、元数处理和结果装箱都在引擎内部完成。热点调用点会通过 DFG/FTL JIT 层编译成直接的本地调用,不需要逐参数的 JavaScript 垫片。Bun 嵌入了 TinyCC,这是一款小巧快速的 C 编译器,仅用于 cc(),它可以在运行时编译你提供的 C 源代码。
用法
Zig
pub export fn add(a: i32, b: i32) i32 {
  return a + b;
}
编译命令:
zig build-lib add.zig -dynamic -OReleaseFast
传入共享库路径和符号映射到 dlopen:
import { dlopen, FFIType, suffix } from "bun:ffi";
const { i32 } = FFIType;

const path = `libadd.${suffix}`;

const lib = dlopen(path, {
  add: {
    args: [i32, i32],
    returns: i32,
  },
});

console.log(lib.symbols.add(1, 2));
Rust
// add.rs
#[no_mangle]
pub extern "C" fn add(a: i32, b: i32) -> i32 {
    a + b
}
编译命令:
rustc --crate-type cdylib add.rs
C++
#include <cstdint>

extern "C" int32_t add(int32_t a, int32_t b) {
    return a + b;
}
编译命令:
# Linux
clang++ -shared -fPIC add.cpp -o libadd.so

# macOS
clang++ -dynamiclib add.cpp -o libadd.dylib
FFI 类型
支持以下 FFIType 值。
FFIType | C 类型 | 别名 |
|---|---|---|
| buffer | char* | |
| cstring | char* | |
| function | (void*)(*)() | fn、callback |
| ptr | void* | pointer、void*、char* |
| i8 | int8_t | int8_t |
| i16 | int16_t | int16_t |
| i32 | int32_t | int32_t, int |
| i64 | int64_t | int64_t, isize |
| i64_fast | int64_t | |
| u8 | uint8_t | uint8_t |
| u16 | uint16_t | uint16_t |
| u32 | uint32_t | uint32_t |
| u64 | uint64_t | uint64_t, usize |
| u64_fast | uint64_t | |
| f32 | float | float |
| f64 | double | double |
| bool | bool | |
| char | char | |
| napi_env | napi_env | 仅限 cc() |
| napi_value | napi_value | 仅限 cc() |
| buffer_length | uint64_t / size_t | 仅限引擎原生(不适用于 cc()) |
buffer 参数必须是 TypedArray 或 DataView。
buffer_length 是 buffer 的配对长度参数:传入你为 buffer 参数传入的同一个 TypedArray/DataView,被调用函数会将该视图的字节长度作为无符号 64 位整数接收。引擎会在调用时从同一个对象读取指针和长度,因此两者始终一致。你无法通过自行传入 view.byteLength 获得这种原子快照,因为在 JavaScript 中提前读取的长度可能会因可调整大小、可增长或已转移的缓冲区而过时。buffer_length 仅可用作参数,并且与 napi 类型一样,不能在 cc() 中使用。
const {
  symbols: { write_all },
} = dlopen(path, {
  // C:size_t write_all(int fd, const void *buf, size_t len)
  write_all: { args: ["i32", "buffer", "buffer_length"], returns: "u64" },
});
const chunk = new TextEncoder().encode("hello");
write_all(1, chunk, chunk); // buf 和 len 都来自 `chunk`
napi_env 和 napi_value 仅在 cc() 源代码中有效。在那里,编译后的跳板函数会用模块的环境填充 napi_env 参数;在该位置传入的 JavaScript 参数只是占位符,会被忽略。napi_value 会原样传递 JavaScript 值。在 dlopen、linkSymbols、JSCallback 或 CFunction 描述符中使用任一类型都会抛出 TypeError。
字符串
JavaScript 字符串和 C 样式字符串不同,这使得在本地库中使用字符串变得复杂。
JavaScript 字符串和 C 字符串有什么不同?
JavaScript 字符串:
- UTF16(每个字符 2 字节)或者可能是 latin1,具体取决于 JavaScript 引擎和使用的字符
length单独存储- 不可变
C 字符串:
- 通常是 UTF8(每个字母 1 字节)
- 不存储长度。相反,字符串以 null 结尾:其长度是第一个
\0的索引 - 可变
为了解决这个问题,bun:ffi 导出了 CString,它会读取指针处的 UTF-8 C 字符串,并返回一个普通的 JavaScript 字符串:
CString(ptr: number, byteOffset?: number, byteLength?: number): string;
从以 null 结尾的字符串指针转换为 JavaScript 字符串:
const myString = new CString(ptr);
从指定长度的指针转换为 JavaScript 字符串:
const myString = new CString(ptr, 0, byteLength);
new CString() 返回普通字符串(typeof myString === "string",myString === "hello" 可正常使用)。该字符串是 C 字符串的副本,因此即使 ptr 已释放,你仍然可以安全地使用它。
const myString = new CString(ptr);
my_library_free(ptr);

// 这很安全,因为 myString 是克隆的
console.log(myString);
在 returns 中使用时,FFIType.cstring 会将指针强制转换为 JavaScript string。在 args 中使用时,FFIType.cstring 接受 ptr 所接受的一切,并且还接受直接传入的 JavaScript 字符串。引擎会将字符串转码为以 null 结尾的 UTF-8 缓冲区,该缓冲区在调用期间有效,因此你无需自行将其编码为 Buffer:
symbols.puts("Hello, world!"); // args: ["cstring"] — 直接传入字符串
cstring 返回值的生命周期。 指针就是 C 函数返回的内容:由原生端拥有的内存(静态内存、它管理的缓冲区或它分配的堆内存)。返回时引擎不会复制任何内容,JavaScript 字符串会从该内存中克隆出来。唯一的别名情况是,C 函数返回了一个_源自你以 JavaScript 字符串形式传入的 cstring 参数_的指针。引擎会将该参数转码到仅在本次调用期间有效的缓冲区,因此应将此类返回指针视为仅在下一次 FFI 调用复用该缓冲区之前有效(这是返回输入内容的函数通常遵循的 C 规则)。请克隆它(通过返回的字符串或 new CString),不要持有原始地址。
函数指针
要从 JavaScript 调用函数指针,请使用 CFunction,例如使用从已加载的 Node-API(napi)模块中获取的指针。
import { CFunction } from "bun:ffi";

let myNativeLibraryGetVersion = /* 你以某种方式获得的指针 */

const getVersion = new CFunction({
  returns: "cstring",
  args: [],
  ptr: myNativeLibraryGetVersion,
});
getVersion();
要一次定义多个函数指针,请使用 linkSymbols:
import { linkSymbols } from "bun:ffi";

// getVersionPtrs 在其他地方定义
const [majorPtr, minorPtr, patchPtr] = getVersionPtrs();

const lib = linkSymbols({
  // 和 dlopen() 不同,这里的名称可以随意
  getMajor: {
    returns: "cstring",
    args: [],

    // 由于不用 dlsym(),必须提供一个有效的指针
    // 该指针可以是 number 或 bigint
    // 无效指针会导致程序崩溃。
    ptr: majorPtr,
  },
  getMinor: {
    returns: "cstring",
    args: [],
    ptr: minorPtr,
  },
  getPatch: {
    returns: "cstring",
    args: [],
    ptr: patchPtr,
  },
});

const [major, minor, patch] = [lib.symbols.getMajor(), lib.symbols.getMinor(), lib.symbols.getPatch()];
回调
使用 JSCallback 创建 JavaScript 回调函数,以便将其传递给 C/FFI 函数,让原生代码能够回调 JavaScript 或 TypeScript。这对于异步代码非常有用。
import { dlopen, JSCallback, ptr, CString } from "bun:ffi";

const {
  symbols: { search },
  close,
} = dlopen("libmylib", {
  search: {
    returns: "usize",
    args: ["cstring", "callback"],
  },
});

const searchIterator = new JSCallback((ptr, length) => /hello/.test(new CString(ptr, 0, Number(length))), {
  returns: "bool",
  args: ["ptr", "usize"],
});

const str = Buffer.from("wwutwutwutwutwutwutwutwutwutwutut\0", "utf8");
if (search(ptr(str), searchIterator)) {
  // 找到匹配!
}

// 过一会儿:
setTimeout(() => {
  searchIterator.close();
  close();
}, 5000);
使用完 JSCallback 后,调用 close() 释放内存。
实验性线程安全回调
JSCallback 实验性支持线程安全回调。如果要将回调函数传递到创建它的线程之外的其他线程,则需要使用此功能。通过可选的 threadsafe 参数启用它。
线程安全回调可从任何线程调用,包括由你的本地库生成、Bun 不会以其他方式获知的线程。引擎会在线程安全回调所在的调用线程上复制 C 参数,并将调用转发到 JavaScript 线程。在那里,引擎会像处理普通回调一样转换参数(i64/u64/usize 参数会以 BigInt 形式传入;指针会以 number 形式传入),并运行你的函数。由于从 C 的角度来看,调用是异步的,因此返回给 C 调用方的值未指定。你可以声明非 void 的 returns(下例使用 "bool"),但 C 端必须将线程安全回调视为返回 void,并忽略其返回值。
const searchIterator = new JSCallback((ptr, length) => /hello/.test(new CString(ptr, 0, Number(length))), {
  returns: "bool",
  args: ["ptr", "usize"],
  threadsafe: true, // 可选,默认为 `false`
});
指针
Bun 在 JavaScript 中将指针表示为 number 类型。
64 位指针如何存放在 JavaScript 数字中?
64 位处理器最多支持 52 位可寻址空间。JavaScript 数字支持 53 位可用空间,因此还剩下 1 位额外空间。
为什么不用 BigInt? BigInt 更慢。JavaScript 引擎会单独分配 BigInt,因此它无法装入常规 JavaScript 值。如果将 BigInt 传递给函数,Bun 会将其转换为 number。
Windows 注意事项:Windows API 类型 HANDLE 不表示虚拟地址,将 ptr 用于 HANDLE 不会 按预期工作。请使用 u64 来安全地表示 HANDLE 值。
将 TypedArray 转换为指针:
import { ptr } from "bun:ffi";
let myTypedArray = new Uint8Array(32);
const myPtr = ptr(myTypedArray);
将指针转换为 ArrayBuffer:
import { ptr, toArrayBuffer } from "bun:ffi";
let myTypedArray = new Uint8Array(32);
const myPtr = ptr(myTypedArray);

// toArrayBuffer 接受 `byteOffset` 和 `byteLength`
// 如果不传 `byteLength`,默认为 null 结尾指针
myTypedArray = new Uint8Array(toArrayBuffer(myPtr, 0, 32), 0, 32);
读取指针数据有两种选择。对于长时效指针,使用 DataView:
import { toArrayBuffer } from "bun:ffi";
let myDataView = new DataView(toArrayBuffer(myPtr, 0, 32));

console.log(
  myDataView.getUint8(0, true),
  myDataView.getUint8(1, true),
  myDataView.getUint8(2, true),
  myDataView.getUint8(3, true),
);
对于短时效指针,使用 read:
import { read } from "bun:ffi";

console.log(
  // ptr, byteOffset
  read.u8(myPtr, 0),
  read.u8(myPtr, 1),
  read.u8(myPtr, 2),
  read.u8(myPtr, 3),
);
read 函数行为类似于 DataView,但通常更快,因为不需创建 DataView 或 ArrayBuffer。
FFIType | read 函数 |
|---|---|
| ptr | read.ptr |
| i8 | read.i8 |
| i16 | read.i16 |
| i32 | read.i32 |
| i64 | read.i64 |
| u8 | read.u8 |
| u16 | read.u16 |
| u32 | read.u32 |
| u64 | read.u64 |
| f32 | read.f32 |
| f64 | read.f64 |
内存管理
bun:ffi 不会替你管理内存。你必须在用完后释放内存。
来自 JavaScript
要跟踪 JavaScript 中不再使用的 TypedArray,请使用 FinalizationRegistry。
来自 C、Rust、Zig 等
要从 C 或 FFI 中跟踪何时不再使用 TypedArray,请向 toArrayBuffer 或 toBuffer 传递一个回调和一个可选的上下文指针。垃圾回收器释放底层的 JavaScript ArrayBuffer 对象后,Bun 会调用该回调。该回调可能会在垃圾回收线程而非 JavaScript 线程上运行,因此不得回调 JavaScript,也不得假设存在特定线程的状态。
预期的签名与 JavaScriptCore 的 C API 一致:
typedef void (*JSTypedArrayBytesDeallocator)(void *bytes, void *deallocatorContext);
import { toArrayBuffer } from "bun:ffi";

// 传递 deallocatorContext:
toArrayBuffer(
  bytes,
  byteOffset,

  byteLength,

  // 这是一个指向上下文的可选指针
  deallocatorContext,

  // 这是一个指向函数的指针
  jsTypedArrayBytesDeallocator,
);

// 不传 deallocatorContext:
toArrayBuffer(
  bytes,
  byteOffset,

  byteLength,

  // 这是一个指向函数的指针
  jsTypedArrayBytesDeallocator,
);
内存安全
不要在 FFI 之外使用原始指针。Bun 的未来版本可能会添加一个 CLI 标志来禁用 bun:ffi。
指针对齐
如果接口期望的是与 char 或 u8 不同大小的指针,确保 TypedArray 也是对应的大小。u64* 和 [8]u8* 并不完全等价,因为对齐要求不同。
传递指针
当 FFI 函数期望指针时,传入对应大小的 TypedArray:
import { dlopen, FFIType } from "bun:ffi";

const {
  symbols: { encode_png },
} = dlopen(myLibraryPath, {
  encode_png: {
    // FFIType 也可以用字符串形式指定
    args: ["ptr", "u32", "u32"],
    returns: FFIType.ptr,
  },
});

const pixels = new Uint8ClampedArray(128 * 128 * 4);
pixels.fill(254);
pixels.subarray(0, 32 * 32 * 2).fill(0);

const out = encode_png(
  // pixels 会作为指针传入
  pixels,

  128,
  128,
);
自动生成的包装器会将 TypedArray 转换为指针。
高难度用法
如果不希望进行自动转换,或者希望获取 TypedArray 内特定字节偏移处的指针,请直接获取指向 TypedArray 的指针:
import { dlopen, FFIType, ptr } from "bun:ffi";

const {
  symbols: { encode_png },
} = dlopen(myLibraryPath, {
  encode_png: {
    // FFIType 也可以用字符串形式指定
    args: ["ptr", "u32", "u32"],
    returns: FFIType.ptr,
  },
});

const pixels = new Uint8ClampedArray(128 * 128 * 4);
pixels.fill(254);

// 这里返回的是数字!不是 BigInt!
const myPtr = ptr(pixels);

const out = encode_png(
  myPtr,

  // 尺寸:
  128,
  128,
);
读取指针
const out = encode_png(
  // pixels 会作为指针传入
  pixels,

  // 尺寸:
  128,
  128,
);

// 假设这是以 0 结尾,可以这样读取:
let png = new Uint8Array(toArrayBuffer(out));

// 写入磁盘:
await Bun.write("out.png", png);